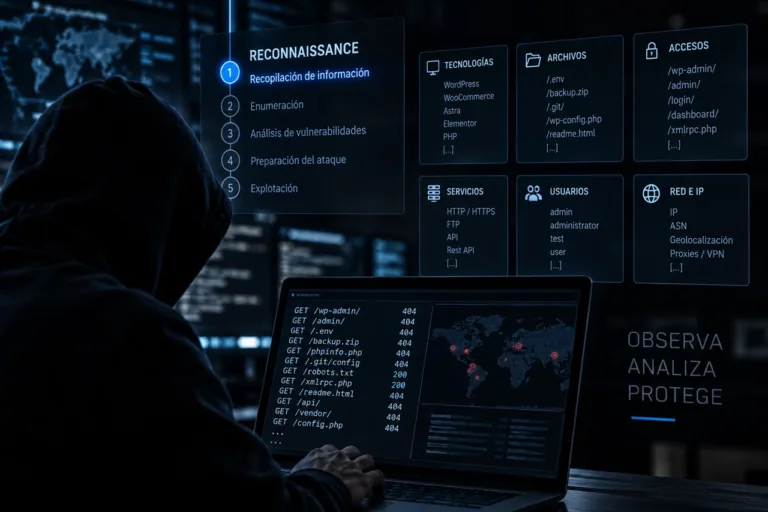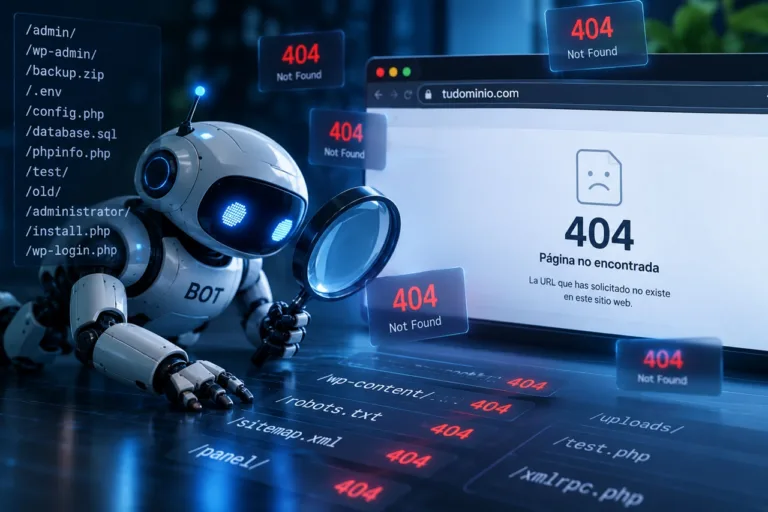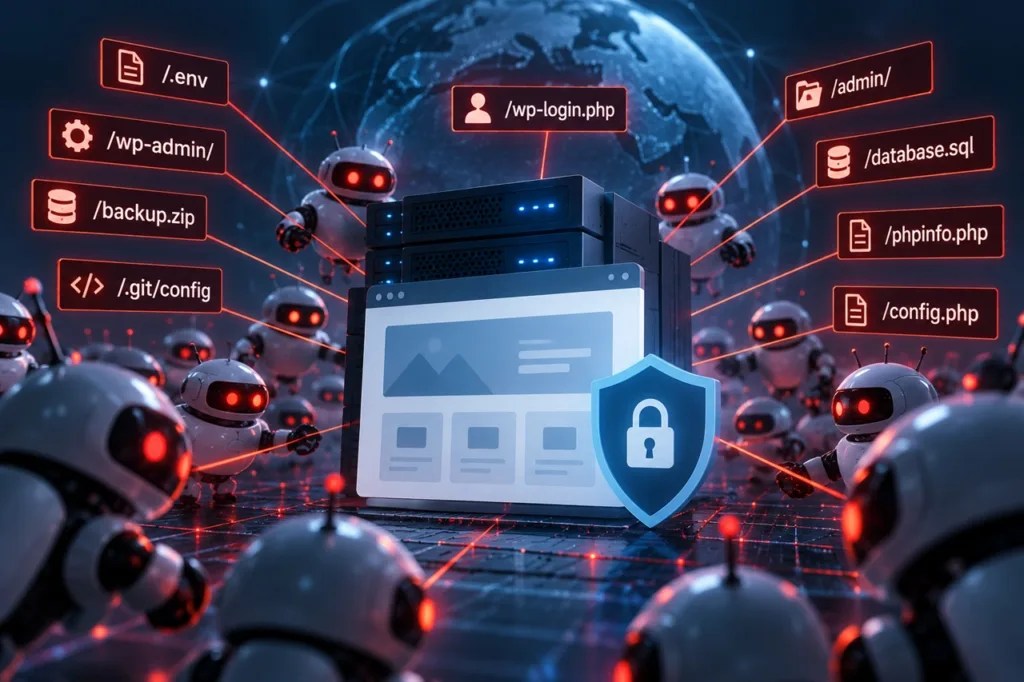
Una página web puede recibir cada día peticiones hacia direcciones que nunca han existido: /.env, /.git/config, /backup.zip, /admin/ o nombres de archivos completamente desconocidos para el propietario de la web.
En muchos casos no se trata de una persona intentando acceder manualmente. Son bots y scanners automatizados que recorren Internet buscando recursos expuestos, tecnologías conocidas y posibles vulnerabilidades.
Entender qué están buscando ayuda a interpretar mejor los registros del servidor y, sobre todo, a distinguir una visita normal de una actividad de reconocimiento.
¿Por qué un bot escanea una página web?
Un atacante no necesita conocer previamente la estructura de una web. Automatizar miles de comprobaciones resulta mucho más sencillo.
Un scanner puede probar una lista de direcciones conocidas contra miles de dominios y analizar qué responde cada servidor.
Por ejemplo, puede solicitar:
/.env
/.git/config
/backup.zip
/database.sql
/admin/
/login/
Que tu web reciba una petición hacia /.env no significa que el atacante sepa que ese archivo existe. Probablemente está preguntando lo mismo a miles de servidores.
1. Archivos con información sensible
Uno de los objetivos más habituales consiste en localizar archivos que puedan contener credenciales, configuraciones internas o información sobre la infraestructura.
Algunos scanners prueban nombres relacionados con configuraciones, variables de entorno, logs o archivos olvidados por desarrolladores y administradores.
/.env
/.env.production
/config.php
/debug.log
/phpinfo.php
La mayoría de estas peticiones terminarán correctamente en un error 404 si el recurso no existe. El problema aparece cuando un archivo sensible ha quedado accidentalmente accesible desde Internet.
2. Copias de seguridad olvidadas
También es frecuente que los bots intenten localizar copias de seguridad utilizando nombres previsibles.
/backup.zip
/site.zip
/database.sql
/web-old.zip
/config.php.bak
/config.php.old
Una copia de seguridad publicada accidentalmente puede ser mucho más peligrosa que la propia página visible, ya que podría contener código fuente, configuraciones o información que nunca debería estar disponible públicamente.
3. Repositorios y código fuente
Los scanners también buscan restos de herramientas utilizadas durante el desarrollo.
Un ejemplo conocido es intentar acceder a recursos relacionados con .git:
/.git/
/.git/config
/.git/HEAD
Un repositorio mal configurado y accesible públicamente puede proporcionar información sobre la estructura y el historial del proyecto. Por eso estos caminos aparecen con frecuencia en escaneos automatizados.
4. Paneles de administración y páginas de acceso
Otro objetivo consiste en descubrir dónde se encuentra el acceso administrativo de una aplicación.
Los bots pueden probar diferentes nombres habituales:
/admin/
/administrator/
/login/
/panel/
/wp-admin/
/wp-login.php
En este caso, encontrar una página de acceso no implica necesariamente que exista una vulnerabilidad. Sin embargo, permite al scanner identificar la tecnología utilizada y decidir qué comprobaciones realizar después.
5. Plugins, componentes y tecnologías conocidas
Muchos ataques automatizados no buscan una vulnerabilidad desconocida. Buscan instalaciones que todavía utilizan componentes para los que ya existe una vulnerabilidad conocida.
Por eso un scanner puede intentar acceder directamente a rutas asociadas con determinados CMS, plugins, librerías o aplicaciones, incluso aunque tu web nunca haya utilizado esos componentes.
Desde fuera puede parecer absurdo: el servidor recibe peticiones hacia archivos que jamás existieron. Para el bot, sin embargo, el coste de probarlos es mínimo.
6. Webshells y archivos dejados por ataques anteriores
Existe otro comportamiento particularmente interesante: scanners que buscan nombres asociados con archivos maliciosos o puertas traseras.
Esto no significa necesariamente que el bot pretenda subir ese archivo en ese momento. Puede estar comprobando si otro atacante ya comprometió anteriormente el servidor y dejó algún recurso accesible.
Una petición hacia un archivo extraño que no existe es inocua para el servidor, pero resulta muy útil para entender qué está intentando descubrir quien realiza el escaneo.
Un error 404 también puede contener información
Es fácil considerar todos los errores 404 como simples páginas no encontradas. Desde el punto de vista de seguridad, no siempre son iguales.
Un usuario que escribe incorrectamente una dirección puede generar un 404. Un crawler puede encontrar un enlace antiguo y producir otro. Y un scanner puede generar decenas o cientos intentando localizar archivos sensibles.
El código HTTP puede ser idéntico. Lo que cambia es el comportamiento que existe detrás de esas peticiones.
Una petición aislada dice poco; una secuencia puede decir mucho
Imaginemos que una dirección IP solicita una URL inexistente. No tenemos suficiente información para concluir prácticamente nada.
Ahora imaginemos que en pocos segundos solicita:
/.env
/.git/config
/backup.zip
/database.sql
/admin/
El contexto cambia. Ya no estamos analizando solamente cinco errores 404, sino un patrón compatible con una fase automatizada de reconocimiento.
Por eso una estrategia moderna de seguridad no debería limitarse únicamente a preguntar si una determinada dirección IP está en una lista negra. También resulta útil analizar qué solicita, con qué frecuencia y qué secuencia de acciones realiza.
¿Todos los bots son peligrosos?
No. Internet está lleno de automatizaciones legítimas: motores de búsqueda, herramientas de monitorización, servicios que generan vistas previas, verificadores técnicos y muchos otros sistemas automatizados.
Por eso bloquear cualquier visitante simplemente por comportarse como un bot sería una mala estrategia.
La clave está en diferenciar entre automatización legítima, tráfico innecesario y comportamiento potencialmente hostil.
Entonces, ¿debo preocuparme si veo estas URLs?
Encontrar este tipo de peticiones en los registros de una web no significa automáticamente que haya sido comprometida.
De hecho, recibir escaneos automatizados es algo habitual en cualquier servidor expuesto a Internet.
Lo importante es comprobar que los recursos sensibles no estén expuestos, mantener el software actualizado, limitar superficies innecesarias y disponer de mecanismos capaces de detectar y responder ante comportamientos claramente abusivos.
Los bots también dejan pistas
Normalmente pensamos en un scanner como algo que intenta obtener información de nuestra web. Pero durante ese proceso también ocurre lo contrario: su comportamiento nos proporciona información sobre él.
Las rutas que prueba, el orden en que las solicita, la velocidad de las peticiones, las tecnologías que busca y la repetición del mismo comportamiento desde diferentes direcciones IP pueden ayudar a identificar patrones.
Y ahí está una de las partes más interesantes de la seguridad web actual: pasar de observar únicamente direcciones IP a intentar comprender comportamientos.