Revisas los registros de tu web y encuentras visitas a páginas que nunca has creado: archivos desconocidos, paneles de administración inexistentes, copias de seguridad o rutas que no tienen ninguna relación con tu sitio. ¿Cómo puede alguien visitar algo que nunca ha existido?
La respuesta es sencilla: para solicitar una URL no es necesario saber previamente si existe.
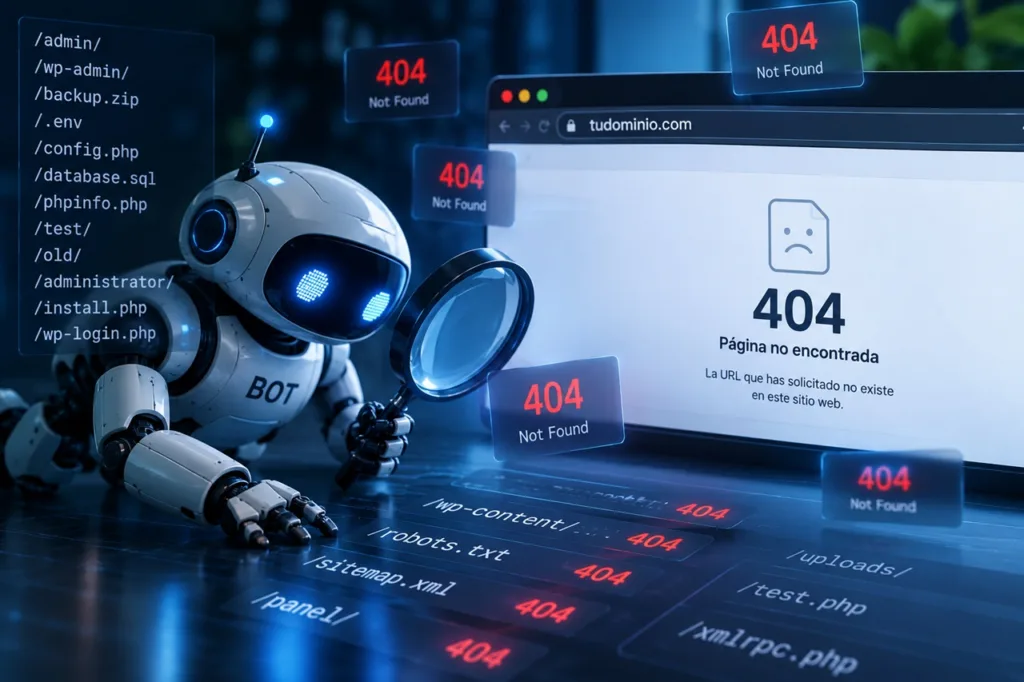
Bots, scanners y otras herramientas automatizadas pueden construir direcciones y probarlas directamente contra miles de páginas web. El servidor recibe la petición y responde, normalmente con un error 404 si el recurso no existe.
No necesitan encontrar un enlace para visitar una URL
Cuando navegamos normalmente por Internet solemos pasar de una página a otra utilizando enlaces. Esto puede crear la impresión de que alguien solo puede llegar a una URL si anteriormente la ha encontrado en algún sitio.
Pero cualquier cliente puede solicitar directamente una dirección al servidor.
Por ejemplo, aunque nunca hayas creado estos recursos:
tudominio.com/backup.zip
tudominio.com/.env
tudominio.com/admin/
tudominio.com/database.sql
un sistema automatizado puede probarlos simplemente construyendo esas direcciones.
Tu servidor será quien responda si existen, si están protegidas o si devuelve un 404.
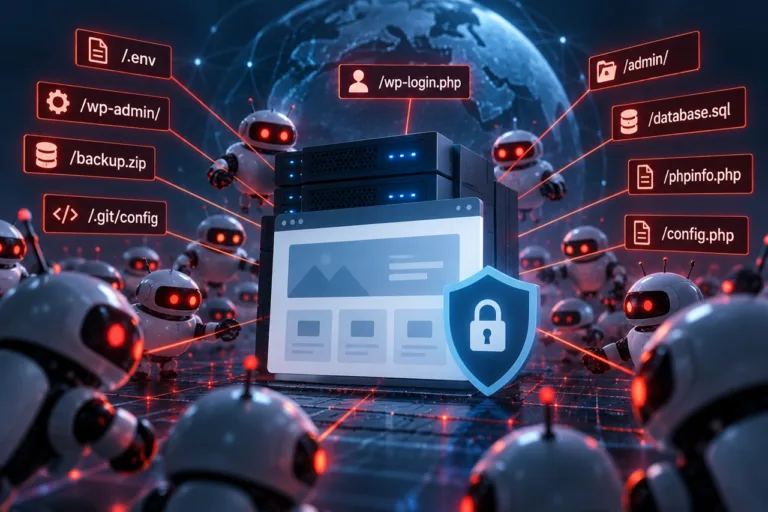
Los bots trabajan con diccionarios de rutas
Una técnica habitual consiste en utilizar listas de nombres de archivos, directorios y endpoints asociados con diferentes tecnologías.
El scanner puede probar automáticamente miles de posibilidades:
/.env
/.git/config
/backup.zip
/database.sql
/admin/
/administrator/
/login/
/wp-admin/
/phpinfo.php
No significa que el atacante sepa que utilizas todos esos recursos. Precisamente está realizando las peticiones para descubrirlo.
También pueden probar tecnologías que nunca has utilizado
Otra situación que suele llamar la atención es encontrar peticiones relacionadas con aplicaciones que nunca han estado instaladas en la web.
Una página desarrollada con una determinada tecnología puede recibir intentos dirigidos contra WordPress, Joomla, paneles de servidores, frameworks, plugins o herramientas completamente diferentes.
El bot no necesariamente sabe qué utilizas. Puede estar probando diferentes tecnologías hasta encontrar alguna respuesta interesante.
¿Por qué hacen tantas pruebas?
Porque automatizarlas resulta barato.
Un scanner no se comporta como una persona que dedica varios minutos a investigar cada página. Puede realizar comprobaciones contra grandes cantidades de dominios y quedarse únicamente con aquellos que responden de una forma determinada.
La mayoría de los intentos no encontrará nada. Pero el sistema está diseñado precisamente para localizar las excepciones.
Una URL inexistente también puede formar parte de un reconocimiento
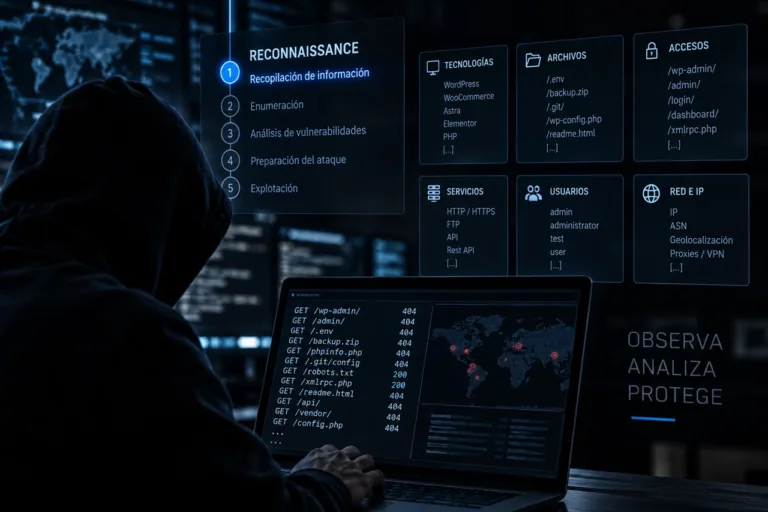
Antes de intentar explotar una vulnerabilidad, algunos sistemas automatizados realizan una fase de reconocimiento.
Buscan conocer qué tecnologías utiliza el sitio, qué archivos están expuestos, dónde se encuentran los accesos administrativos o si existe algún recurso conocido que merezca una comprobación adicional.
Por eso una petición hacia una página inexistente no siempre representa un intento directo de entrar en la web. Puede ser simplemente una pregunta automatizada:
¿Existe este recurso en este servidor?
La respuesta puede ser un simple 404 y el scanner continuará con la siguiente prueba.
No todos los errores 404 significan lo mismo
Aquí aparece una diferencia importante.
Un visitante puede escribir mal una dirección. Google puede intentar rastrear una URL antigua. Otra web puede conservar un enlace que ya no existe. Un recurso puede haber cambiado de ubicación.
Todos esos casos pueden producir un error 404 perfectamente normal.
Pero también puede ocurrir esto:
/.env
/.git/config
/backup.zip
/database.sql
/phpinfo.php
/admin/
solicitado por la misma dirección IP en pocos segundos.
El resultado técnico puede seguir siendo una colección de errores 404, pero el comportamiento es completamente diferente.
La secuencia puede ser más importante que una URL concreta
Analizar cada petición de forma aislada puede ocultar información interesante.
Una solicitud hacia /admin/, por ejemplo, dice relativamente poco. Puede existir incluso una explicación legítima.
Pero si el mismo origen solicita decenas de archivos sensibles, paneles administrativos y copias de seguridad en pocos segundos, comienza a aparecer un patrón compatible con un scanner automatizado.
Esto permite pasar de una pregunta muy simple:
¿Esta URL existe?
a otra mucho más interesante desde el punto de vista de seguridad:
¿Qué está intentando descubrir este visitante?
¿Debes bloquear cualquier IP que provoque un 404?
No. Sería una medida demasiado agresiva.
Los errores 404 forman parte del funcionamiento normal de Internet. Bloquear automáticamente a cualquier visitante que solicite una página inexistente podría afectar a usuarios reales, motores de búsqueda y otros servicios legítimos.
Lo que resulta más interesante es combinar diferentes señales: cantidad de peticiones, velocidad, rutas solicitadas, repetición, tipo de recursos buscados y comportamiento anterior.
¿Debes preocuparte cuando encuentras estas visitas?
Encontrarlas no significa por sí mismo que tu página haya sido hackeada.
Cualquier servidor accesible desde Internet puede recibir tráfico automatizado y pruebas hacia recursos inexistentes.
Lo importante es que archivos sensibles, copias de seguridad, configuraciones y accesos que no deberían ser públicos estén correctamente protegidos.
También conviene observar los patrones. Una URL inexistente puede no decir prácticamente nada; cientos de peticiones relacionadas en pocos segundos pueden contar una historia muy diferente.
Los 404 también ayudan a entender lo que ocurre en tu web
Los errores 404 no sirven únicamente para descubrir enlaces rotos.
Cuando analizamos su origen, frecuencia y las rutas solicitadas también pueden mostrarnos cómo crawlers, bots y scanners están interactuando con nuestro servidor.
Y algunas de esas peticiones aparentemente absurdas pueden convertirse en señales muy útiles para entender el tráfico automatizado que recibe una página web.