Muchos ataques web no empiezan intentando entrar directamente en un sistema. Antes puede existir una fase de reconocimiento en la que bots, scanners o atacantes recopilan información sobre la web, sus tecnologías, accesos y recursos expuestos.
En ciberseguridad esta fase suele denominarse reconocimiento o reconnaissance. Su objetivo es obtener información que permita decidir qué comprobar después y dónde pueden existir oportunidades de ataque.
¿Qué es el reconocimiento web?
El reconocimiento consiste en recopilar información sobre un objetivo antes de realizar acciones posteriores.
En una página web puede significar intentar descubrir qué tecnología utiliza, qué servicios están accesibles, dónde se encuentran determinados paneles, qué archivos responden o qué componentes parecen estar instalados.
No todo reconocimiento implica necesariamente que vaya a producirse un ataque. Parte de esta actividad puede proceder de herramientas automatizadas, investigadores, crawlers o sistemas de análisis. El contexto y el comportamiento son importantes para interpretar lo que está ocurriendo.
¿Qué información pueden intentar descubrir?
Dependiendo del objetivo y de las herramientas utilizadas, durante una fase de reconocimiento pueden buscarse diferentes tipos de información.
- La tecnología o CMS utilizado por la web.
- Paneles de administración o páginas de acceso.
- Plugins, módulos, temas o componentes instalados.
- Archivos de configuración expuestos accidentalmente.
- Copias de seguridad olvidadas en el servidor.
- Repositorios o archivos relacionados con el código fuente.
- Endpoints, APIs y servicios accesibles públicamente.
- Información sobre el servidor y su infraestructura.
Una parte de esta información puede ser pública y completamente normal. El reconocimiento consiste precisamente en reunir diferentes señales para construir una imagen más completa del objetivo.
Reconocimiento pasivo y reconocimiento activo
Una distinción útil es separar el reconocimiento pasivo del activo.
Reconocimiento pasivo
Busca obtener información sin interactuar directamente, o reduciendo al mínimo la interacción, con el sistema analizado.
Por ejemplo, puede utilizar información que ya es pública: resultados de buscadores, registros DNS, documentación, repositorios públicos o datos publicados por la propia organización.
Reconocimiento activo
Implica interactuar directamente con la infraestructura o la aplicación para observar cómo responde.
Solicitar determinadas URLs, comprobar recursos conocidos o analizar respuestas del servidor son ejemplos de actividades que pueden formar parte de un reconocimiento activo.
¿Por qué aparecen URLs extrañas durante un reconocimiento?
Una de las señales más visibles para el administrador de una web son las peticiones hacia rutas que aparentemente no tienen ningún sentido.
/.env
/.git/config
/backup.zip
/database.sql
/admin/
/wp-admin/
/phpinfo.php
El scanner no necesita saber que estos recursos existen. Puede solicitarlos precisamente para descubrir si están disponibles.
Por eso es posible recibir visitas a URLs que nunca han existido en tu página web. El servidor recibe la petición, comprueba el recurso solicitado y responde, frecuentemente con un error 404.
Una petición aislada puede decir muy poco
Encontrar una única solicitud hacia /admin/ no permite determinar automáticamente que alguien esté preparando un ataque.
Puede tratarse de una petición accidental, una herramienta automatizada o simplemente ruido habitual de Internet.
El análisis se vuelve más interesante cuando observamos varias acciones relacionadas.
/.env
/.git/config
/backup.zip
/database.sql
/wp-admin/
/phpinfo.php
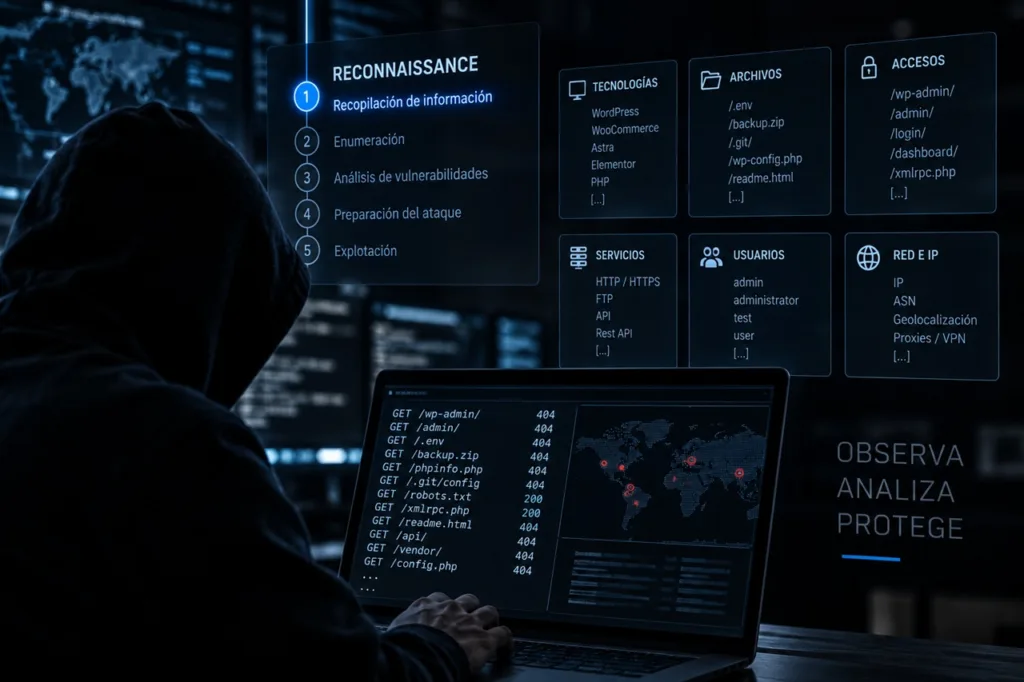
Si un mismo origen realiza numerosas comprobaciones de este tipo en pocos segundos, el conjunto puede mostrar un patrón mucho más compatible con un scanner realizando reconocimiento.
La secuencia de peticiones también aporta información
No solamente importa qué URLs se solicitan. También puede resultar útil observar el orden, la frecuencia y el intervalo entre las peticiones.
Un sistema automatizado puede seguir una secuencia relativamente repetitiva para identificar tecnologías, comprobar recursos y decidir qué acciones realizar después.
Esto permite analizar el comportamiento de forma más amplia, en lugar de considerar cada URL como un evento completamente independiente.
El reconocimiento no siempre procede de una única IP
Otro aspecto importante es que la dirección IP no siempre representa por sí sola todo el comportamiento.
Los sistemas automatizados pueden utilizar diferentes servidores, proxies u otras infraestructuras distribuidas. Como consecuencia, actividades similares pueden aparecer desde direcciones IP distintas.
Por eso, además de observar la IP, puede ser útil analizar otras señales como las rutas solicitadas, la velocidad de las peticiones, su secuencia, las respuestas obtenidas y otros patrones de comportamiento.
Reconocimiento no significa que la web haya sido comprometida
Este punto es especialmente importante.
Detectar un scanner o peticiones compatibles con una fase de reconocimiento no significa que el atacante haya conseguido entrar en la web.
En muchos casos únicamente estamos observando intentos de descubrir qué existe y qué tecnología utiliza el sitio.
Un servidor correctamente configurado puede responder a cientos de estas comprobaciones sin exponer ningún recurso sensible.
¿Qué puedes hacer frente al reconocimiento automatizado?
No es realista intentar impedir que alguien solicite cualquier URL pública de un servidor conectado a Internet. La prioridad debe ser reducir la información innecesariamente expuesta y evitar que una comprobación encuentre algo que no debería ser público.
- Mantener aplicaciones, plugins y componentes actualizados.
- No almacenar copias de seguridad en ubicaciones públicamente accesibles.
- Proteger archivos de configuración y otros recursos sensibles.
- Eliminar instalaciones, archivos y componentes que ya no se utilizan.
- Revisar logs y patrones de tráfico cuando sea necesario.
- Utilizar controles de seguridad adecuados para detectar comportamientos abusivos.
De observar URLs a entender comportamientos
El reconocimiento muestra por qué analizar seguridad únicamente a partir de direcciones IP o URLs individuales puede quedarse corto.
Una petición aislada puede ser irrelevante. Una secuencia de peticiones, repetida con determinados intervalos y buscando tipos concretos de recursos, puede aportar mucha más información.
Entender estos patrones ayuda a distinguir mejor entre navegación normal, ruido automatizado y actividades que merecen una observación más detallada.