Cuando revisamos el tráfico de una página web aparecen términos como crawler, bot, scanner o atacante. A primera vista pueden parecer lo mismo: sistemas automáticos que visitan una web sin que haya una persona navegando detrás.
Sin embargo, no significan lo mismo ni representan necesariamente el mismo nivel de riesgo.
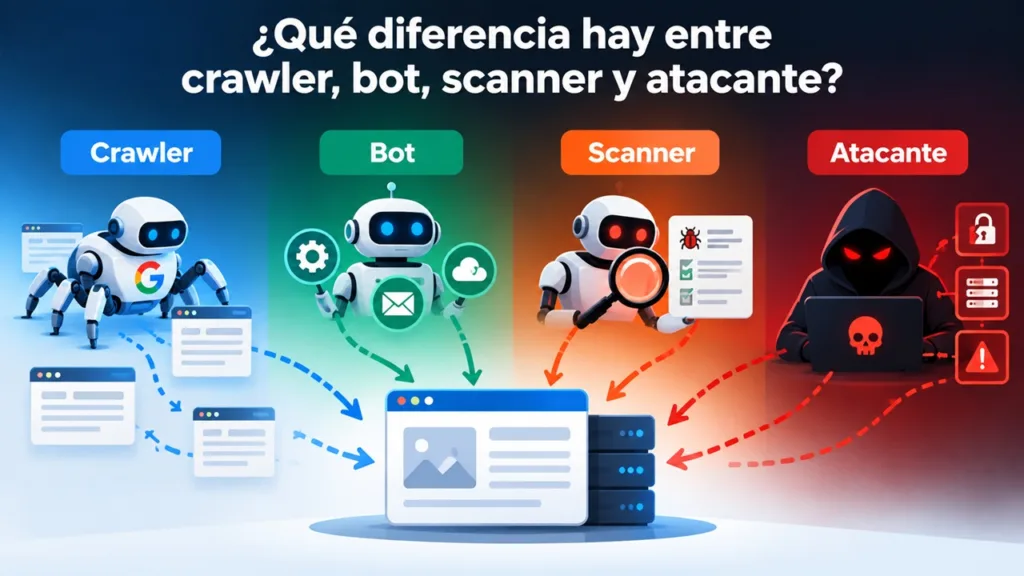
Un crawler de un buscador puede ser necesario para que una página aparezca en los resultados de búsqueda. Un bot puede realizar una tarea perfectamente legítima. Un scanner puede estar buscando vulnerabilidades y un atacante puede intentar directamente explotar una de ellas.
Entender estas diferencias ayuda a interpretar mejor el tráfico de una web y, sobre todo, a evitar dos errores: bloquear automatizaciones legítimas o permitir tráfico realmente hostil.
¿Qué es un crawler?
Un crawler, también llamado rastreador o araña web, es un sistema automatizado que recorre páginas y enlaces para descubrir y analizar contenido.
Los motores de búsqueda utilizan crawlers para descubrir páginas, interpretar su contenido y mantener actualizados sus índices. Por eso, el rastreo forma parte del funcionamiento normal de Internet y del SEO.
Un crawler normalmente sigue enlaces, solicita documentos HTML y otros recursos, identifica nuevas URLs y vuelve periódicamente a páginas que ya conoce.
Por tanto, que una visita sea automatizada no significa que sea peligrosa.
¿Qué es un bot?
Bot es un término mucho más amplio. Describe cualquier programa que realiza tareas automáticamente en Internet.
Un crawler es, técnicamente, un tipo de bot. Pero no todos los bots son crawlers.
Existen bots utilizados para monitorización, buscadores, comprobación de disponibilidad, servicios de seguridad, integraciones entre plataformas y muchas otras funciones legítimas.
También existen bots utilizados para enviar spam, crear cuentas falsas, probar credenciales, recopilar información de forma abusiva o generar grandes cantidades de peticiones.
Por eso, clasificar todo el tráfico automatizado simplemente como “bot” aporta poca información. Lo realmente importante es saber qué está haciendo ese bot.
¿Qué es un scanner?
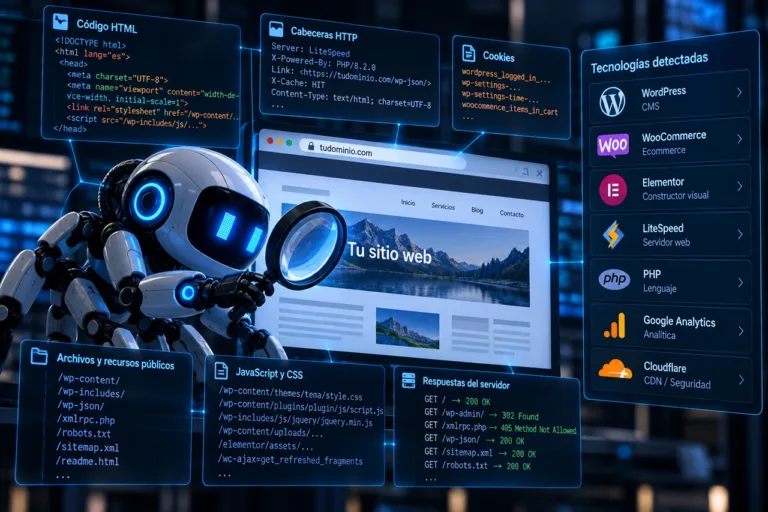
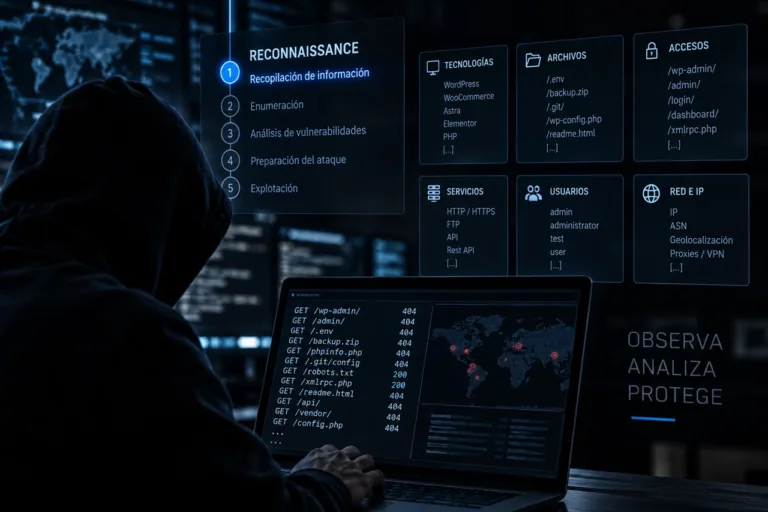
Un scanner es un sistema automatizado que examina una web, servidor o servicio buscando determinadas características, configuraciones o posibles vulnerabilidades.
Por ejemplo, puede comprobar si existen determinadas rutas, versiones de software, paneles de administración, archivos expuestos o componentes conocidos.
El contexto es especialmente importante en este caso.
Un scanner puede formar parte de una auditoría de seguridad autorizada. Pero también puede utilizarse para localizar objetivos vulnerables antes de intentar un ataque.
Por eso, detectar actividad de scanning no demuestra automáticamente que exista un ataque en curso, pero puede representar una fase de reconocimiento que merece atención.
¿Qué es un atacante?
Hablamos de atacante cuando existe una actividad hostil orientada a comprometer, alterar, abusar o acceder sin autorización a un sistema.
El atacante puede ser una persona, pero gran parte de estas acciones se ejecutan mediante herramientas automatizadas.
Entre los comportamientos que pueden aparecer están los intentos reiterados de acceso, explotación de vulnerabilidades, abuso de formularios o endpoints, enumeración de usuarios y solicitudes dirigidas contra recursos sensibles.
La diferencia fundamental no está únicamente en la tecnología utilizada, sino en el comportamiento, el contexto y la intención observable de las solicitudes.
Crawler, bot, scanner y atacante: diferencias principales
| Tipo | Qué hace | ¿Es necesariamente peligroso? |
|---|---|---|
| Crawler | Recorre páginas y enlaces para descubrir o analizar contenido | No |
| Bot | Automatiza una tarea en Internet | No |
| Scanner | Examina sistemas, rutas, servicios o posibles vulnerabilidades | No necesariamente |
| Atacante | Realiza acciones hostiles contra un sistema | Sí, por definición |
Además, estas categorías no siempre son excluyentes. Un bot puede actuar como crawler, un scanner puede ser un bot y un atacante puede utilizar scanners y otros bots como parte de su actividad.
El comportamiento importa más que la etiqueta
Uno de los problemas de analizar tráfico web únicamente mediante nombres o etiquetas es que estas pueden resultar engañosas.
Por ejemplo, identificarse con el nombre de un buscador conocido no demuestra por sí solo que una petición proceda realmente de ese buscador. Del mismo modo, una dirección IP desconocida no significa automáticamente que exista una amenaza.
Para interpretar correctamente una visita automatizada conviene observar diferentes señales: frecuencia de las peticiones, URLs solicitadas, repetición de errores, acceso a rutas sensibles, origen del tráfico, comportamiento a lo largo del tiempo y relación con otras solicitudes.
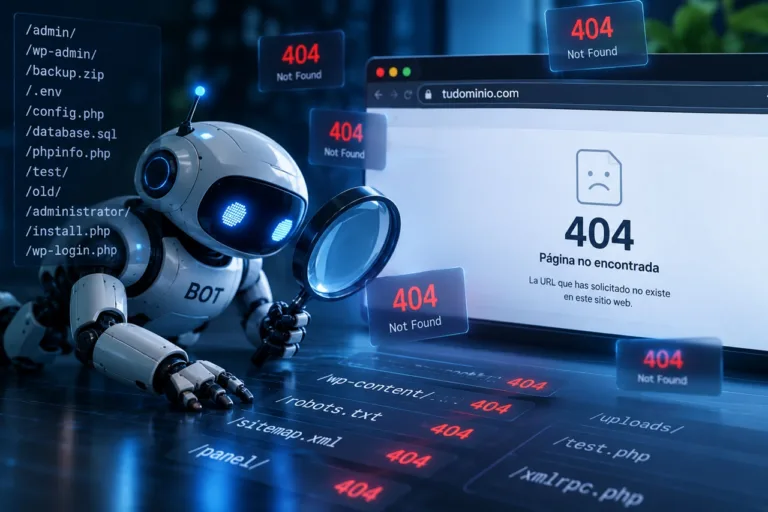
Una petición aislada a una URL inexistente puede no tener ninguna importancia. Cientos de solicitudes consecutivas buscando archivos, rutas administrativas o recursos que nunca han existido en la web cuentan una historia diferente.
¿Por qué una web recibe tantos bots?
Una página publicada en Internet puede comenzar a recibir tráfico automatizado incluso aunque tenga pocas visitas humanas.
Esto ocurre porque muchos sistemas recorren constantemente direcciones IP, dominios y páginas públicas. Algunos buscan contenido, otros recopilan información y otros intentan localizar servicios o configuraciones vulnerables.
Por eso, recibir peticiones automatizadas no significa necesariamente que alguien haya elegido manualmente esa web como objetivo. Una parte importante del tráfico automatizado funciona de forma masiva y continua.
¿Hay que bloquear todos los bots?
No. Bloquear indiscriminadamente cualquier tráfico automatizado puede provocar problemas.
Una web puede necesitar permitir el acceso de crawlers de buscadores y de otros servicios legítimos. Al mismo tiempo, puede ser conveniente limitar automatizaciones abusivas o bloquear actividad claramente hostil.
La protección eficaz consiste en distinguir entre automatización legítima, actividad sospechosa y comportamiento hostil, en lugar de tratar todas las solicitudes automáticas de la misma manera.
Un mismo origen puede cambiar de comportamiento
La clasificación tampoco tiene por qué ser permanente.
Una dirección IP puede realizar inicialmente unas pocas peticiones normales y posteriormente comenzar a explorar rutas sensibles de forma repetitiva. También puede ocurrir lo contrario: una actividad poco habitual puede tener finalmente una explicación legítima.
Por este motivo, los sistemas de seguridad modernos no deberían depender exclusivamente de listas estáticas. El historial y la evolución del comportamiento aportan información importante para decidir cuándo observar, limitar o bloquear una actividad.
Conclusión
Crawler, bot, scanner y atacante no son sinónimos.
Un crawler rastrea contenido. Un bot automatiza tareas. Un scanner examina sistemas o recursos. Un atacante realiza acciones hostiles, aunque para hacerlo pueda utilizar bots, crawlers o scanners.
La clave para proteger correctamente una web está en analizar qué ocurre realmente detrás de cada petición: qué solicita, con qué frecuencia, contra qué recursos, desde dónde y cómo evoluciona ese comportamiento con el tiempo.
Porque en seguridad web, saber que una visita es automática es solo el principio. Lo importante es entender qué está intentando hacer.
Preguntas frecuentes
¿Un crawler es un bot?
Sí. Un crawler puede considerarse un tipo de bot especializado en recorrer páginas, enlaces y contenidos.
¿Todos los bots son peligrosos?
No. Existen numerosos bots legítimos utilizados por buscadores, servicios de monitorización, herramientas de seguridad y otras plataformas.
¿Un scanner significa que están atacando mi web?
No necesariamente. Puede tratarse de una herramienta legítima de análisis, aunque el scanning también puede utilizarse como fase previa para identificar posibles vulnerabilidades.
¿Debo bloquear cualquier IP que haga muchas peticiones?
No necesariamente. El volumen es una señal, pero debe analizarse junto con otros factores como las URLs solicitadas, la frecuencia, el patrón de navegación, el origen y el historial de comportamiento.
¿Puede un bot hacerse pasar por un buscador?
Sí. La identificación declarada por una petición no debería considerarse por sí sola una prueba suficiente de que el tráfico pertenece realmente al servicio que afirma representar.